O maior risco em uma consulta de dados em massa via API não está apenas no volume: permissões amplas, processamento sem controle e paginação inconsistente podem comprometer a segurança e a integridade dos resultados. Reduza esses riscos com autenticação, limites de requisição, filtros bem definidos e validação das respostas. A API intermedeia o acesso aos dados sem expor diretamente o banco à aplicação consumidora.
O alto volume exige mais do que automatizar chamadas. É preciso entender como cada requisição é autorizada, processada e registrada, além de verificar se as páginas retornadas formam um conjunto completo e coerente. Sem esses controles, a integração pode criar gargalos, expor campos desnecessários ou gerar dados incompletos.
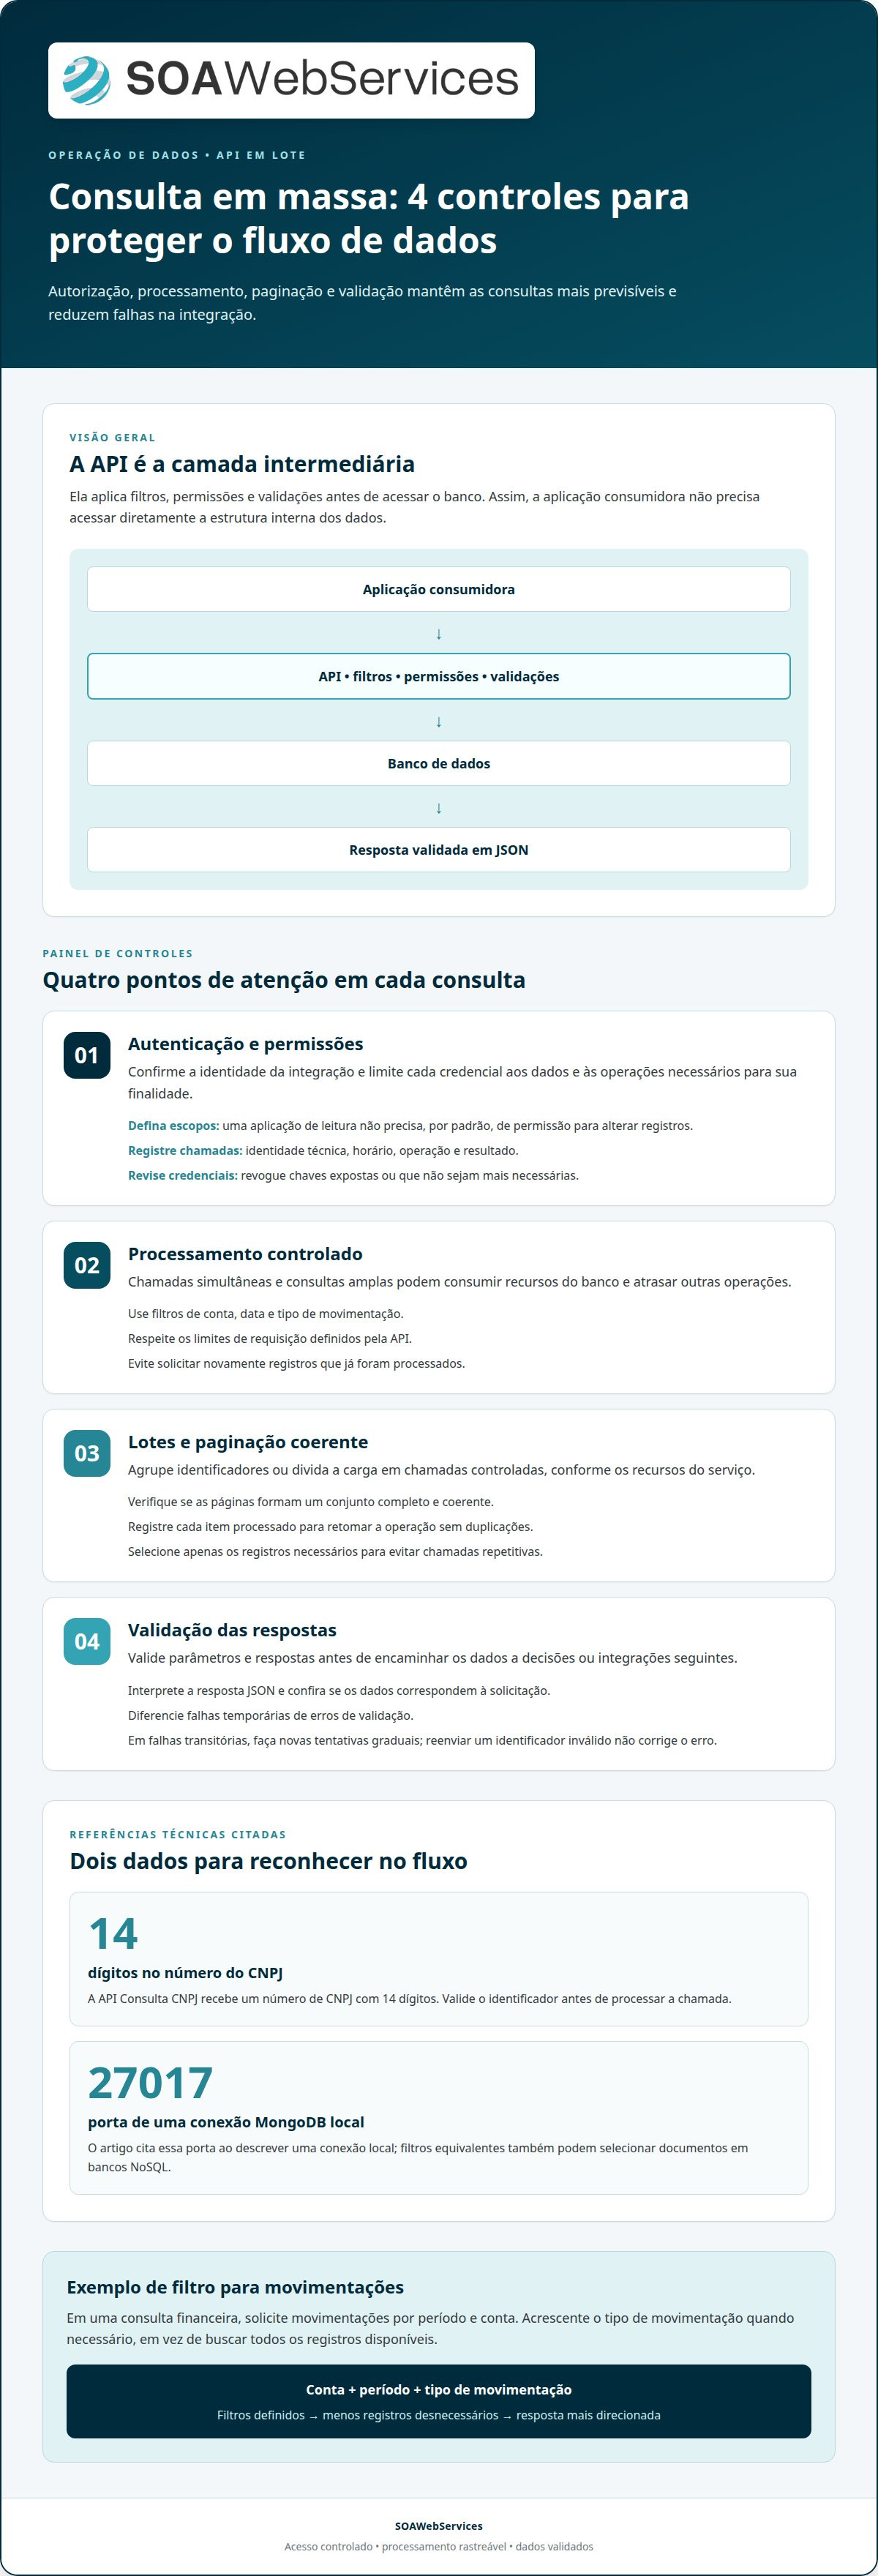
Neste artigo, você vai acompanhar o fluxo de uma consulta em massa e avaliar os principais pontos de atenção em acesso, processamento, paginação e consistência. Também vai entender como filtros, limites, padronização das respostas e monitoramento ajudam a tornar a operação mais previsível e segura para os sistemas que consomem os dados.
Principais conclusões
- Use a API como camada de acesso entre aplicações e bancos de dados, mantendo regras e permissões fora da estrutura interna do banco.
- Defina autenticação, escopo de acesso e registro de operações para reduzir exposição indevida e facilitar auditorias.
- Controle o processamento das requisições e considere limites de acesso para evitar sobrecarga durante consultas volumosas.
- Combine filtros e paginação consistentes para recuperar os registros necessários sem criar chamadas repetitivas ou gargalos.
- Valide a qualidade e a consistência das respostas antes de usá-las em decisões ou integrações subsequentes.
Conceito de APIs como intermediárias entre aplicações e bancos de dados
Uma API funciona como interface entre a aplicação consumidora e o banco, sem exigir acesso direto à estrutura interna. Em consultas de movimentações de Caixa e Bancos, por exemplo, essa camada organiza filtros, permissões e respostas antes de entregar os registros ao sistema financeiro.
Papel das APIs na comunicação com bancos de dados
Uma API intermedeia operações de leitura e escrita, aplicando validações antes de acessar tabelas ou coleções. Isso é importante quando diferentes aplicações precisam consultar os mesmos dados sem depender da organização interna do banco.
Em SQL, uma requisição pode pedir movimentos de Caixa e Bancos por período e conta, e a API traduz os parâmetros para uma consulta estruturada. Em bancos NoSQL, filtros equivalentes selecionam documentos; uma conexão MongoDB local usa a porta 27017. A resposta costuma ser JSON, formato que simplifica a integração entre sistemas.
Consultas ineficientes e sobrecarga do banco
Uma consulta ineficiente solicita registros demais ou repete operações sem necessidade, consumindo recursos do banco. Isso ocorre, por exemplo, quando um relatório busca todas as movimentações bancárias, embora precise apenas dos dados de uma conta e de um período.
Esse padrão importa porque chamadas simultâneas podem aumentar a carga e atrasar outras operações. Use filtros de conta, data e tipo de movimentação; evite solicitar novamente registros já processados. A API pode centralizar essas regras e impedir que cada aplicação faça consultas amplas diretamente.
Provedores e fontes brasileiras de APIs
Compare os provedores pelo tipo de dado, pelos filtros disponíveis, pelo formato das respostas, pela documentação e pelos limites de acesso. Para escolher uma integração, identifique primeiro a fonte e o nível de detalhe necessários, como uma consulta de CNPJ ou de movimentações financeiras.
No Brasil, a Receita Federal do Brasil administra o CNPJ, e a API Consulta CNPJ recebe um número com 14 dígitos. Fontes oficiais são os órgãos responsáveis pelos dados e seus canais de publicação; a oferta pode ser uma API para consultas específicas ou um conjunto disponibilizado em massa. Não existe uma interface única que reúna todos os dados públicos.
Consultas em lote com API REST/JSON e tratamento de erros
Uma consulta em lote com API REST/JSON pode agrupar identificadores ou dividir a carga em chamadas controladas, de acordo com os recursos oferecidos pelo serviço. Envie parâmetros válidos, interprete a resposta JSON e registre cada item processado para retomar a operação sem duplicações.
Antes de repetir uma chamada, diferencie uma falha temporária de um erro de validação: reenviar um identificador inválido não corrige o problema. Respeite os limites de requisição definidos pela API e faça novas tentativas graduais diante de falhas transitórias. Assim, o processamento fica rastreável e as chamadas redundantes diminuem.
Autenticação, permissões e regras de negócio
Em consultas em massa de dados pessoais, organize o fluxo considerando a finalidade da operação, os campos solicitados e os controles de acesso. A relação entre a LGPD e cada tratamento depende do contexto; por isso, registre as decisões e encaminhe dúvidas jurídicas para avaliação apropriada.
Autenticação e permissões de acesso
A autenticação confirma a identidade de quem tenta acessar a API; as permissões definem quais dados e operações essa identidade pode usar. Essa separação ajuda a limitar o alcance de cada credencial. Por exemplo, um serviço que valida cadastros pode ter acesso de leitura aos campos necessários para essa tarefa, sem permissão para alterar registros.
Defina escopos de acesso por aplicação e finalidade operacional. Uma integração de análise cadastral pode ter permissões diferentes das de um sistema que atualiza informações. Restrinja também os parâmetros aceitos, valide os identificadores e impeça consultas fora do contexto previsto para cada credencial.
Registre cada chamada com a identidade técnica, o horário, a operação e o resultado. Esses eventos permitem rastrear acessos e investigar padrões atípicos, como uma credencial consultando registros aparentemente alheios à sua função. Se uma chave for exposta ou deixar de ser necessária, revogue-a e revise as permissões relacionadas.
As regras de negócio podem complementar esses controles. Uma consulta, por exemplo, pode exigir que o identificador tenha formato válido e que os parâmetros correspondam à operação solicitada. Rejeitar entradas inválidas antes de acessar o banco ajuda a manter o processamento alinhado à finalidade definida para a integração.
Aplicação da LGPD a consultas em massa
Para avaliar a relação entre a LGPD e uma consulta em massa, documente o contexto do tratamento: quais dados entram no fluxo, para que serão usados e quais sistemas os recebem. Esse inventário ajuda as equipes técnica e jurídica a analisar a operação concreta, sem presumir que uma única configuração serve para todos os casos.
Como medida operacional, limite a resposta aos campos necessários para a tarefa. Se uma integração precisa validar um cadastro, evite incluir atributos sem uso nesse fluxo. Mascarar dados nas telas de suporte e restringir o acesso aos registros técnicos também ajuda a controlar a exposição durante a operação.
Mapeie onde as respostas são armazenadas, quais perfis podem acessá-las e quando as cópias temporárias deixam de ser úteis. Ao revisar a integração, compare os dados enviados e recebidos com o processo que os utiliza. Esse levantamento oferece elementos concretos para avaliar riscos e encaminhar questões de interpretação jurídica.
Ao estruturar esses controles para uma integração, converse sobre requisitos de acesso e tratamento de dados. Registre as decisões operacionais antes de ampliar o volume consultado e mantenha cada permissão vinculada a uma necessidade identificável.
Fluxo de requisição, processamento e resposta
Uma chamada percorre etapas definidas: o sistema envia parâmetros, a API valida a solicitação, processa a consulta e devolve um resultado. Em um lote de CPFs, acompanhar cada etapa ajuda a localizar falhas sem confundir um erro de entrada com a indisponibilidade do serviço.
Etapas de requisição e processamento
O fluxo de requisição e processamento transforma os parâmetros enviados pela aplicação em uma resposta estruturada. Essa sequência é importante porque cada validação pode interromper uma solicitação inválida antes que ela consuma recursos do banco.
Primeiro, o sistema consumidor envia uma solicitação HTTP com os identificadores e filtros necessários. O método GET costuma representar uma leitura; o POST pode enviar dados ou iniciar um processamento, conforme o contrato da API. Parâmetros ausentes ou em formato incorreto devem gerar um retorno identificável, não um resultado ambíguo.
Em seguida, a API valida a entrada, aplica as regras previstas e consulta a fonte de dados. A aplicação consumidora recebe a resposta, interpreta o conteúdo e registra o resultado associado à solicitação original. Em um lote cadastral, esse vínculo permite identificar quais registros foram processados e quais precisam de correção.
Separe erros de transporte, como uma conexão interrompida, de erros de conteúdo, como um identificador inválido. Essa classificação orienta a próxima ação: repetir uma chamada interrompida pode fazer sentido; reenviar um dado malformado sem alterações tende a reproduzir o erro. Registre também o método HTTP, os parâmetros relevantes e o estado retornado.
Tratamento de respostas assíncronas
Uma resposta assíncrona confirma o recebimento de uma tarefa antes de entregar o resultado final. Esse modelo é relevante quando o processamento de um lote não termina durante a conexão inicial e permite que a aplicação continue outras operações.
Para receber e processar respostas assíncronas, guarde o identificador da tarefa, associe-o ao lote enviado e acompanhe seu estado. A API pode oferecer consulta de status ou notificação de conclusão; processe o resultado somente depois de associá-lo à solicitação correspondente.
Ao iniciar uma tarefa, salve o identificador retornado junto aos registros do lote. Se a API disponibilizar notificações, valide a origem e associe cada evento ao identificador esperado. Se o acompanhamento ocorrer por consultas de status, controle a frequência para evitar chamadas repetidas enquanto a tarefa estiver em processamento.
Ao concluir, grave separadamente o resultado, os itens rejeitados e a causa informada para cada falha. Uma rotina poderá então reprocessar somente os registros que podem ser corrigidos, sem reenviar todo o lote. Use uma chave de correlação estável para impedir que notificações repetidas criem registros duplicados no sistema consumidor.
Por fim, defina estados claros, como recebido, em processamento, concluído e falha. Eles ajudam o usuário a acompanhar o andamento e permitem que a equipe técnica identifique tarefas paradas ou resultados ainda não incorporados. Preserve o histórico de tentativas para reconstruir a sequência de eventos.
Filtros, paginação e padronização das respostas
Os filtros delimitam os registros consultados, enquanto a paginação divide resultados extensos em partes processáveis. Não há um limite universal para requisições ou tamanho de lote: cada API define essas condições no contrato e pode restringir chamadas, quantidade de itens ou volume das respostas.
Aplicação de filtros e paginação
Os filtros selecionam quais registros entram na consulta; a paginação distribui os resultados em páginas ou blocos. Essa combinação é importante porque solicitar apenas os dados necessários reduz respostas desnecessárias e chamadas repetitivas.
Por exemplo, uma consulta de empresas pode filtrar pela situação cadastral e ordenar os resultados por CNPJ. A aplicação solicita a página seguinte pelo mecanismo previsto na API, como deslocamento ou cursor. Mantenha a mesma ordenação durante a navegação para reduzir o risco de duplicar ou ignorar registros.
Os filtros também precisam ser validados antes do envio. Por exemplo, uma data inicial posterior à data final deve ser corrigida ou rejeitada pela aplicação consumidora. Em consultas extensas, combine condições seletivas com paginação, em vez de solicitar todos os registros e descartar a maioria depois.
Padronização das respostas e limites de consulta
Padronizar respostas significa manter uma estrutura previsível para resultados e erros. Isso importa porque o sistema consumidor precisa interpretar cada retorno sem depender de formatos diferentes para a mesma operação.
Um contrato consistente pode apresentar os dados, o estado da consulta e os detalhes do erro em campos definidos. Se uma página falhar, a aplicação identifica a ocorrência e evita tratá-la como uma resposta completa. A padronização também facilita a comparação entre registros recebidos em páginas distintas.
Os limites variam conforme a configuração da API: podem abranger chamadas por intervalo, itens aceitos por lote ou tamanho máximo da resposta. Trate esses limites como parâmetros operacionais definidos no contrato, não como valores presumidos. A aplicação deve registrar a rejeição por excesso e ajustar a carga conforme a regra informada.
Organize o processamento para que cada página possa ser retomada sem reenviar o conjunto já concluído. Por exemplo, armazene o cursor recebido junto ao estado da consulta; após uma interrupção, continue do ponto registrado. Se a API usar numeração de páginas, guarde a última página processada e confirme o resultado antes de avançar.
Uma resposta uniforme também deve distinguir uma página sem resultados de uma falha de acesso. No primeiro caso, a consulta terminou sem registros para aqueles filtros; no segundo, o sistema precisa tratar o erro conforme seu tipo. Essa distinção evita registrar ausência de dados quando, na verdade, a chamada não foi concluída.
- Defina filtros que representem a necessidade da consulta.
- Use a ordenação e o mecanismo de paginação previstos pela API.
- Registre cursores, páginas concluídas, erros e respostas recebidas.
- Ajuste o lote aos limites descritos no contrato da integração.
Com esses controles, uma consulta de dados em massa via API mantém a rastreabilidade entre filtros, páginas e respostas. A aplicação consegue identificar o que foi processado, retomar o fluxo e evitar interpretar resultados incompletos como um conjunto íntegro.
Qualidade e consistência dos dados
Valide cada resposta antes de armazená-la: confira o formato, os campos obrigatórios e a correspondência entre identificador e registro. Para atualizar dados retornados pela API, associe a origem e o momento da consulta ao registro, compare a resposta nova com a anterior e aplique uma regra definida para tratar divergências.
A validação começa pelo contrato da API. Se um campo de data precisa seguir um formato específico, rejeite ou sinalize valores que não possam ser interpretados. Em um cadastro empresarial, confira se o CNPJ recebido corresponde ao solicitado e se os campos essenciais foram preenchidos.
Valide também as relações entre campos, não apenas os valores isolados. Um endereço pode conter município e unidade federativa incompatíveis; um registro pode apresentar uma situação cadastral sem o identificador esperado. Encaminhe esses casos para uma fila de revisão, em vez de sobrescrever automaticamente dados já utilizados.
Antes de persistir uma resposta, elimine duplicações pela chave que identifica o registro no sistema consumidor. Se duas páginas retornarem a mesma empresa, uma operação de atualização idempotente evita a criação de cadastros duplicados. Preserve o identificador da consulta para relacionar o dado recebido à solicitação original.
No armazenamento, separe os dados consultados dos metadados da integração. Guarde a fonte, o horário de recebimento, a versão do esquema e o estado da validação. Esses elementos permitem rastrear por que um campo mudou e identificar se a alteração veio da API ou de uma transformação interna.
Atualizações exigem critérios claros. Compare a nova resposta com o valor armazenado e altere somente os campos previstos pela integração. Por exemplo, se a API retorna um telefone vazio, não substitua automaticamente um telefone válido sem uma regra explícita para interpretar campos ausentes.
Defina a frequência de atualização de acordo com o uso dos dados e a capacidade da fonte. Um cadastro usado em uma operação pontual pode seguir uma política diferente de um dado necessário em verificações recorrentes. Registre a data da consulta e o motivo da atualização para distinguir informação recente de informação apenas armazenada.
Monitore a qualidade com verificações por campo: presença, formato, duplicidade e coerência com a chave consultada. Quando um lote apresenta erros concentrados em determinado atributo, suspenda a importação desse campo e preserve os registros válidos. Assim, uma falha localizada não compromete toda a base consumidora.
Para dados pessoais, limite cópias e acessos ao necessário para a finalidade definida. Remova registros temporários quando deixarem de ser úteis ao fluxo operacional e controle quais perfis podem consultar o histórico. Essa separação reduz a exposição em ambientes de análise, suporte e produção.
SOAWebServices: Biometria Facial
A SOAWebServices oferece Biometria Facial para operações que precisam validar a identidade do usuário antes de liberar acesso a um fluxo de dados. A API de validação biométrica é um serviço que oferece prova de vida, anti-spoofing e face match para confirmar identidade. Esse controle é relevante quando uma consulta envolve dados pessoais e a aplicação precisa associar a solicitação a uma pessoa validada.
Considere essa etapa junto às permissões e regras de acesso: a validação biométrica não substitui a definição dos dados que cada perfil pode consultar. Ela pode complementar a autenticação em processos que exigem confirmação de identidade antes da consulta.
Prepare a integração para a próxima etapa
Uma operação de consulta de dados em massa via API deve evoluir junto com as decisões que precisa sustentar. Antes de ampliar o uso, defina quais processos vão consumir os resultados, como a equipe tratará exceções e quais indicadores mostram se os dados atendem à necessidade operacional.
Quando o fluxo também exige informações cadastrais, análise de crédito ou validação de identidade, considere serviços alinhados a cada finalidade. A SOAWebServices oferece Consulta CPF/CNPJ e Biometria Facial. Cada recurso pode atender a uma necessidade distinta da operação, conforme as regras de acesso e o uso previsto para os dados.
Defina a próxima prioridade da integração e estabeleça critérios claros para avaliar os resultados. Com uma finalidade bem delimitada, fica mais simples direcionar as consultas e ajustar o processamento ao fluxo real da empresa.
Avance com objetivos claros e uma arquitetura preparada para apoiar decisões consistentes.
Perguntas frequentes
Quais riscos e pontos de atenção precisam entrar no radar?
Os principais riscos são tratar respostas parciais como completas, usar dados desatualizados e perder a associação entre solicitações e resultados. Em uma carga de CPFs, por exemplo, compare os identificadores enviados com os resultados recebidos e mantenha uma lista dos itens pendentes. Monitore também as falhas por etapa: uma interrupção durante a importação pode deixar parte do sistema consumidor atualizada e outra parte incompleta.
Como autenticar e enviar uma consulta em massa via API?
Use as credenciais e o método de autenticação previstos no contrato da API, mantendo segredos fora do código-fonte e de planilhas compartilhadas. Em uma consulta de dados em massa via API, envie os identificadores e filtros no formato aceito, valide a resposta e associe cada resultado ao registro de origem. Separe as credenciais de teste e produção para evitar que uma rotina experimental consulte dados reais por engano.
Quais riscos de segurança e privacidade existem ao consultar dados em massa via API?
Os riscos incluem credenciais expostas, cópias de dados pessoais em registros técnicos e acesso indevido por sistemas que não precisam dessas informações. Por exemplo, registrar o corpo completo de uma resposta em ferramentas de diagnóstico aumenta os locais em que dados sensíveis ficam armazenados. Reduza essa exposição mascarando campos nos registros, restringindo ambientes de teste e removendo arquivos temporários após o uso operacional.
Quais provedores de API de dados em massa existem e como se comparam?
A Receita Federal do Brasil administra o CNPJ, e a API Consulta CNPJ recebe um número de CNPJ com 14 dígitos. Provedores podem ser comparados pelo tipo de dado, filtros, formato de resposta, documentação e limites de acesso.